El llms.txt es un archivo de texto que se pone en la raíz de un sitio, en la misma ubicación que el robots.txt, con un resumen del sitio y una lista de enlaces a las páginas que el dueño considera más útiles para un modelo de lenguaje. La idea es que un asistente de IA, en lugar de recorrer todo el HTML, lea ese archivo y vaya directo a lo importante.
En los últimos meses me lo encontré en auditorías como un error a corregir, en propuestas de agencias como parte de un servicio de GEO y en plugins que lo generan solo con un clic. Mi posición es bastante simple: para posicionar en Google no sirve, para la mayoría de los sitios de empresas de servicios no cambia nada, y hay un tipo de sitio puntual en el que sí lo pondría. Abajo explico por qué, con los datos que hay hoy.
De dónde sale
La propuesta la publicó Jeremy Howard el 3 de septiembre de 2024 en llmstxt.org. Parte de un problema real: las ventanas de contexto de los modelos son chicas para leer un sitio entero, y convertir HTML lleno de menús, scripts y publicidad en texto limpio es difícil y poco preciso.
El formato es Markdown. Lo único obligatorio es un título con el nombre del sitio o del proyecto. Después se recomienda un resumen corto en un bloque de cita, algunos párrafos de contexto si hacen falta y secciones con listas de enlaces, cada uno con una nota opcional que explique qué hay ahí. Hay además una sección llamada “Optional” para los enlaces que el modelo puede saltear si tiene poco espacio. La propuesta también sugiere ofrecer una versión en Markdown de cada página, en la misma URL con “.md” al final.
Un detalle que casi nadie cuenta es que el propio autor dice que espera que el archivo sea útil sobre todo en el momento de responder, cuando un asistente necesita leer algo para contestar una pregunta, y no para entrenar modelos. O sea que nunca se planteó como una señal de posicionamiento, se planteó como una ayuda de lectura.
Lo que dice Google Search
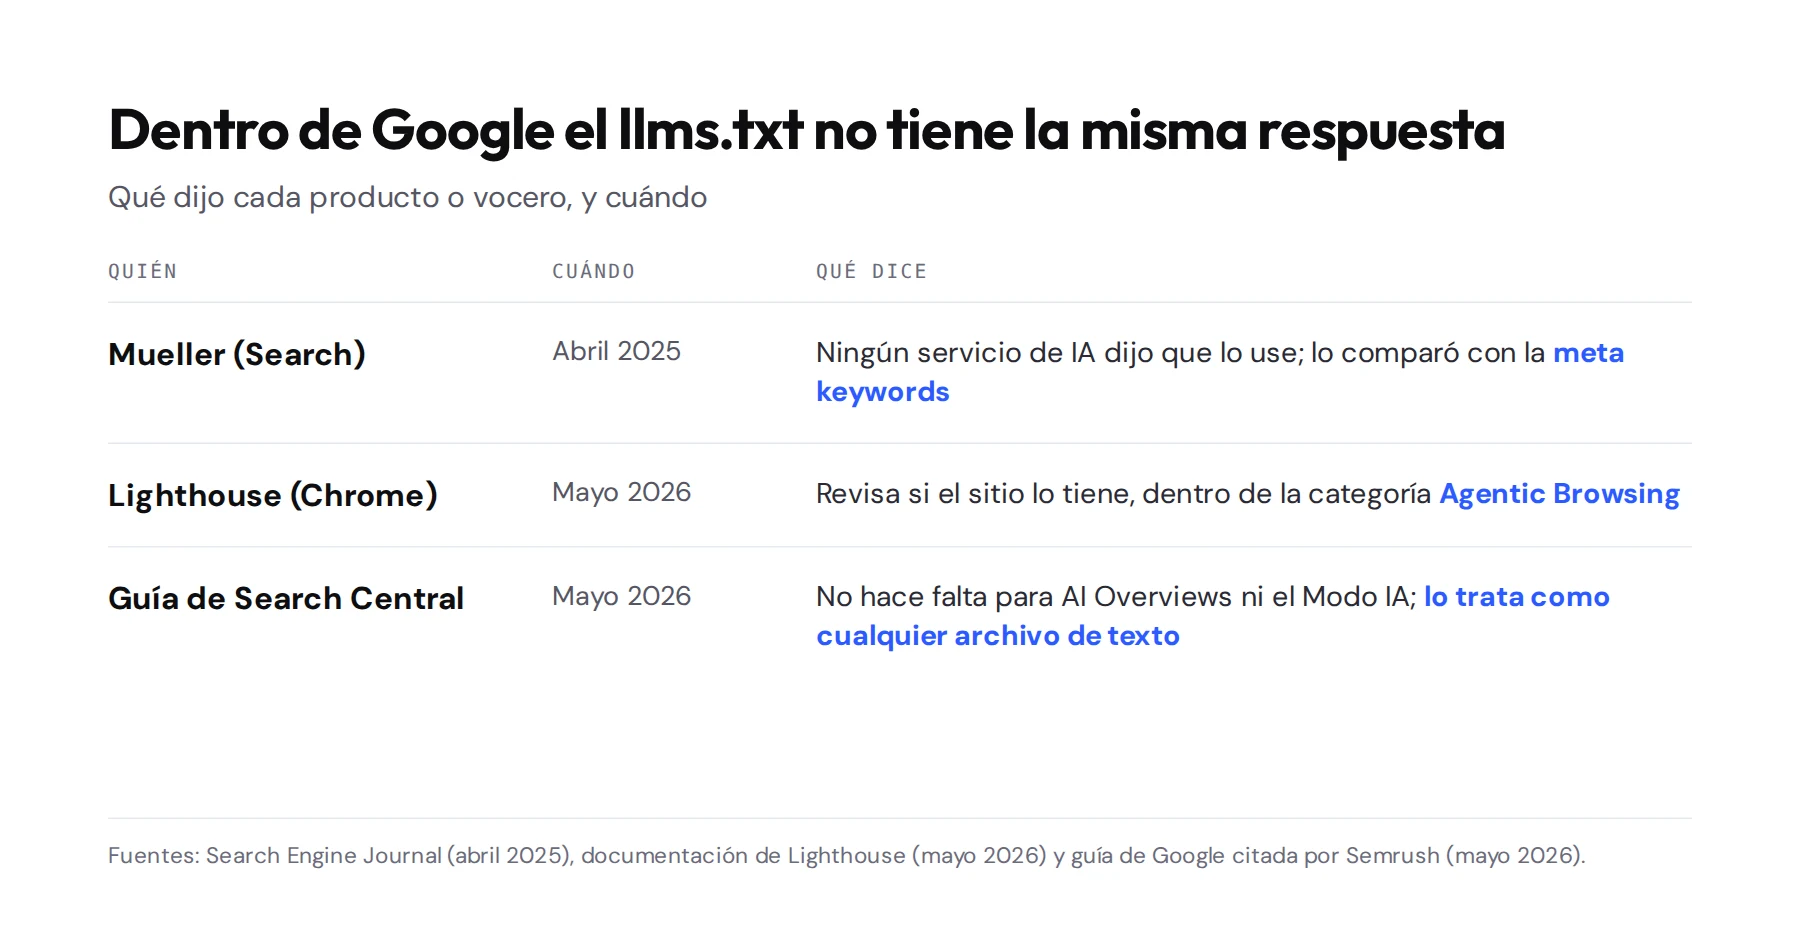
En mayo de 2026 Google publicó en Search Central una guía para optimizar los sitios para AI Overviews y el Modo IA, en la cual hay una sección completa sobre lo que no hace falta hacer, y el llms.txt figura ahí junto con los archivos especiales para IA, el marcado extra y las versiones en Markdown. La guía aclara además que el rastreador de Google puede encontrar estos archivos pero los trata como a cualquier otro archivo de texto, y reconoce que otros rastreadores sí podrían usarlos, algo que Semrush también destacó al cubrir la publicación. Para aparecer en esas respuestas la guía pide lo mismo que pedía antes, que la página esté indexada y que pueda mostrarse con un fragmento en la búsqueda común, por lo cual la conclusión de Google es que optimizar para la búsqueda con IA sigue siendo SEO, y la verdad es que coincido.
Esto no fue una sorpresa. En abril de 2025 John Mueller, de Google, ya había respondido en un hilo de Reddit sobre el tema que, hasta donde él sabía, ningún servicio de IA había dicho que usara el archivo, y que en los registros del servidor se ve que ni siquiera lo piden. En esa misma respuesta lo comparó con la meta keywords, la etiqueta en la que el dueño del sitio declaraba de qué trataba su página y que los buscadores dejaron de tener en cuenta hace muchos años.
Este ciclo ya lo vi varias veces. Llega un cambio importante, aparece un acrónimo nuevo, se vende como una categoría distinta, salen consultoras y herramientas especializadas, y al tiempo Google publica la documentación que confirma lo que un SEO con criterio venía haciendo desde el principio. Pasó con la búsqueda por voz, pasó con AMP, y con el llms.txt está pasando algo muy parecido.
Y lo que dice Chrome
Acá aparece la parte que confunde, y es entendible que confunda. Lighthouse, la herramienta de Chrome que muchos usan para medir velocidad y accesibilidad, incluye desde su versión 13.3, de mayo de 2026, una categoría llamada Agentic Browsing, pensada para los agentes que navegan sitios en nombre de una persona. Dentro de esa categoría hay una revisión que comprueba si el sitio tiene un llms.txt en la raíz.
Entonces tenemos dos productos de Google diciendo cosas distintas, y Google no explicó la diferencia. Yo lo leo así: el equipo de Search habla de cómo se arman las respuestas del buscador, y ahí el archivo no pesa, mientras que el equipo de Chrome mira otra cosa, que es cuánto le cuesta a un agente entender la estructura de un sitio cuando entra a hacer una tarea. Son dos preguntas distintas, y que Lighthouse lo revise no significa que vaya a mover una posición en Google ni una aparición en AI Overviews.
Lo que muestran los registros del servidor
Hay una forma muy simple de salir de la discusión, que es ir a los logs y ver quién pide el archivo. Ahrefs lo hizo a lo grande con los registros de unos 137.000 dominios de mayo de 2026, y Search Engine Journal lo publicó en junio. Más o menos 28 de cada 100 dominios tenían el archivo publicado, y de esos archivos 97 de cada 100 no tuvieron una sola visita en el mes.
Los pocos que sí tuvieron visitas las recibieron sobre todo de herramientas de auditoría SEO, de bots que no se identifican y de rastreadores como Googlebot. En cambio, los bots que usan ChatGPT y Perplexity para buscar información mientras responden fueron cerca del 1% de los pedidos. Dentro de los bots de IA, los que más lo pidieron fueron los agentes de programación, con Claude Code entre los primeros, y hay un dato que me hizo reír bastante: Slackbot lo pidió más veces que PerplexityBot.
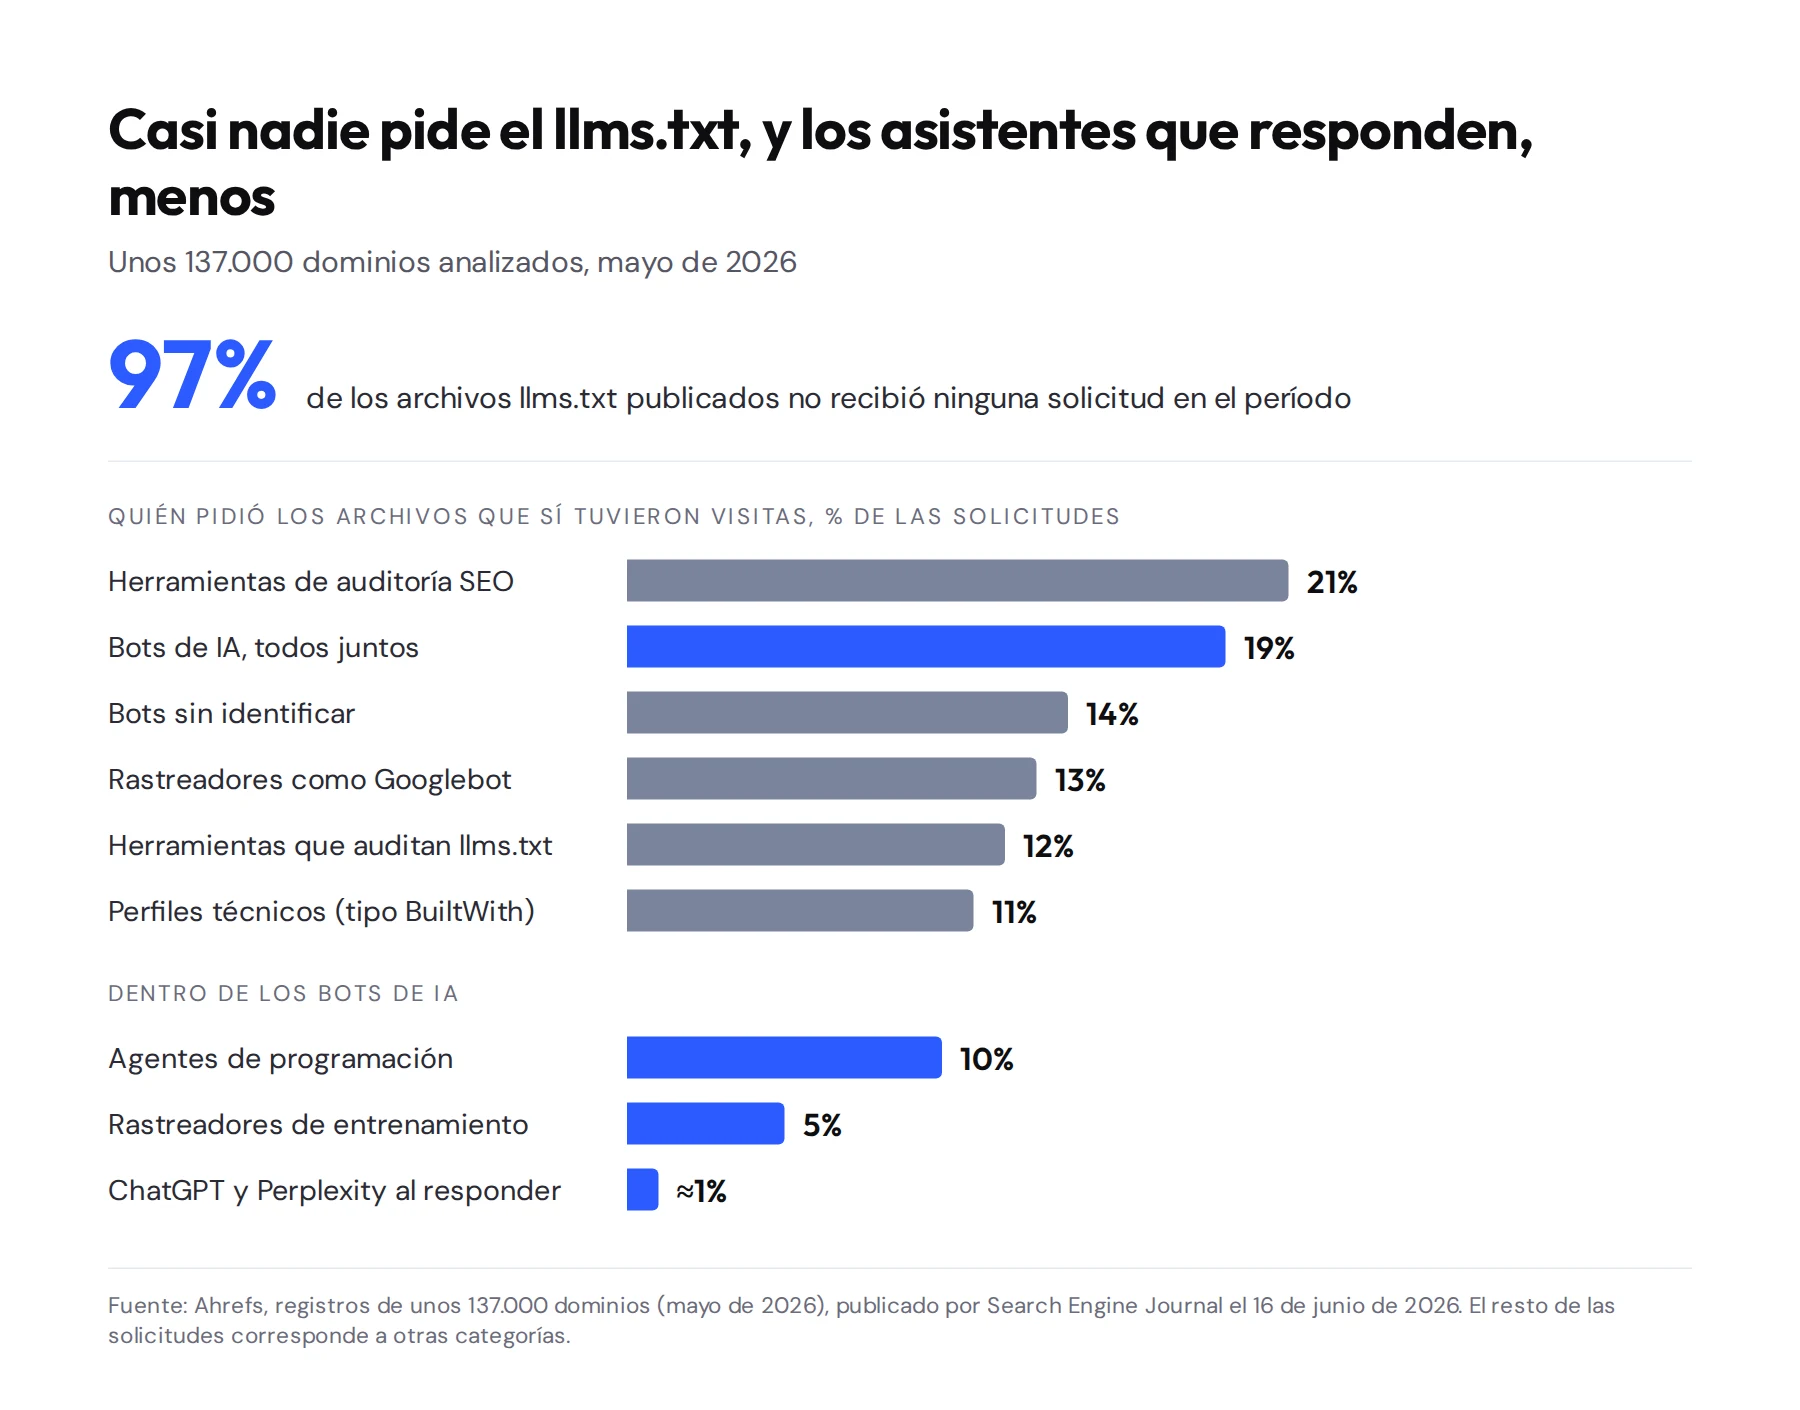
Hay que leer este estudio con cuidado. Los clientes de Ahrefs son más técnicos que el promedio, así que el 28% de adopción probablemente esté inflado, y que un bot pida un archivo no prueba que lo use para algo. Aun así, la conclusión se sostiene: hoy los asistentes que responden preguntas de usuarios casi no lo están leyendo.
Lo que tienen escrito
El otro dato sale de Common Crawl, la fundación que rastrea la web y deja esos datos abiertos para cualquiera. El 31 de agosto publicaron un análisis, firmado por Malte Ostendorff, de los llms.txt que encontraron en julio, y lo que miraron fue el contenido de cada archivo. Fueron 584.107 en total. El 68,27% eran plantillas que nadie escribió, y Wix sola explica cuatro de cada diez archivos. Entre los otros generadores aparecen dos plugins de WordPress que casi todos conocemos, All in One SEO y Yoast.
Y la calidad acompaña poco. Apenas la mitad, el 49,90%, tiene la estructura completa que pide la propuesta, y el 22,56% no trae ni un enlace, que es justamente lo que debería tener. También aparecieron archivos con frases pensadas para darle órdenes al modelo que los lea, y otros que declaran qué bots pueden entrar cuando el robots.txt del mismo sitio dice otra cosa. Para bloquear un rastreador hay que hacerlo en el robots.txt, porque escribirlo en el llms.txt no bloquea nada.
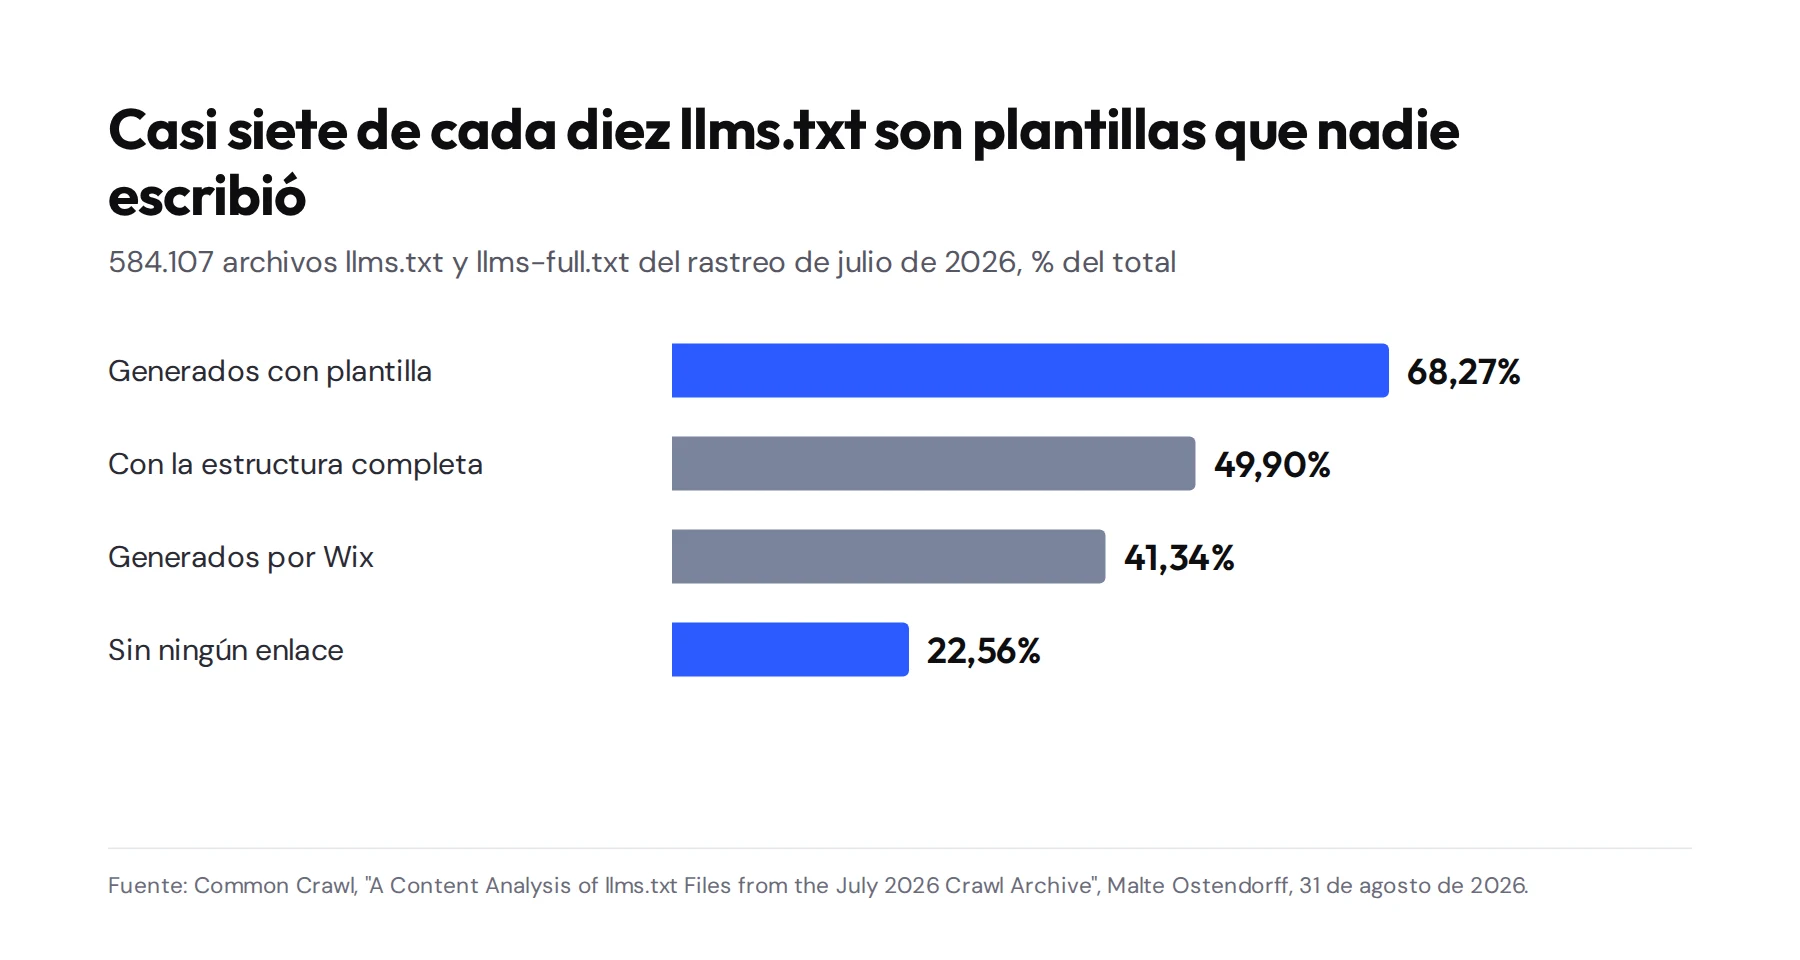
A mí este número me dice más que cualquier opinión, sea de Google o de una agencia. Si la mayoría de los archivos salieron de un plugin y nadie los revisó, el llms.txt promedio no hace lo que prometía la propuesta, que era darle al modelo una selección armada por alguien que conoce el sitio. Es el menú copiado en otro formato.
Cuándo lo pondría y cuándo no
Donde sí lo pondría es en un sitio de documentación técnica, de una API o de un software que usan desarrolladores, porque ellos trabajan cada vez más con un asistente de programación abierto al lado. Ahí el dato de Ahrefs juega a favor: los agentes de programación fueron los que más pidieron el archivo, y un índice prolijo con las páginas de referencia en Markdown le ahorra vueltas al agente y a la persona que lo usa. Hasta Mueller, que nunca defendió el archivo, dijo en mayo de 2026 que las versiones en Markdown de la documentación les pueden servir a esas herramientas, aunque lo llamó una muleta temporal.
Para una empresa de servicios, un comercio o un medio no es prioridad. Si alguien lo arma a mano, eligiendo bien qué páginas poner, no hace daño y cuesta poco, así que no voy a pelear contra eso. Lo que no haría es activarlo desde el plugin y darlo por hecho, porque el resultado es un archivo genérico con el menú del sitio que no le sirve a nadie, y encima queda la sensación de que ya se trabajó la parte de IA cuando en realidad no se hizo nada.
En las auditorías técnicas lo saqué de la lista de problemas prioritarios para los clientes que dependen de Google. Si una herramienta lo marca como hallazgo, lo pongo en contexto en una línea, ya que puede ser un extra para otros modelos pero no es algo que frene a Google, y sigo con lo que de verdad mueve resultados, que casi siempre está en la parte técnica, en el contenido y en las menciones de la marca en otros sitios.
Y si una agencia te lo vende como parte de un servicio de GEO, pregúntale qué respuesta de qué asistente cambió después de publicarlo, y en qué fecha lo midió. Si no hay una medición antes y después, lo que te están vendiendo es un archivo.
Lo que puede cambiar
Este tema no está cerrado, y no quiero que nadie lea este artículo como si lo estuviera. La propuesta todavía cambia, Chrome ya lo revisa y los agentes que entran a un sitio para comprar o reservar algo en nombre de una persona recién están empezando, así que si dentro de un año alguno de los grandes asistentes anuncia que lo usa, vuelvo sobre esto y lo actualizo.
Mientras tanto, la forma más honesta de saber si a tu sitio le sirve es mirar los registros del servidor y ver quién pide el archivo y cada cuánto. Si después de unos meses solo lo piden herramientas de auditoría, ya tienes la respuesta. Y si lo que te interesa es aparecer en las respuestas de los asistentes, el trabajo está en otro lado, en el que conté en el artículo sobre qué es GEO y en el que hacemos todos los días como agencia GEO.